CASE AIC-2026-11졸업작품 구상구상 · 웹 데모
이거 AI야?
SNS 압축에도 버티는 AI 이미지·영상 판별기
AI 표시가 있는지 먼저 확인하고, 없으면 내용을 분석해 AI 표시 확인됨 · AI 의심 N% · 판단 어려움 셋 중 하나로 정직하게 알려 준다.
- 데모 판별 모델이 학습한 생성기 수 (이미지 270만 장)Community Forensics · CVPR 2025
- 4,803개
- 결과는 셋뿐: AI 표시 확인됨 · AI 의심 N% · 판단 어려움"가짜"라고 단정하지 않는다
- 3가지
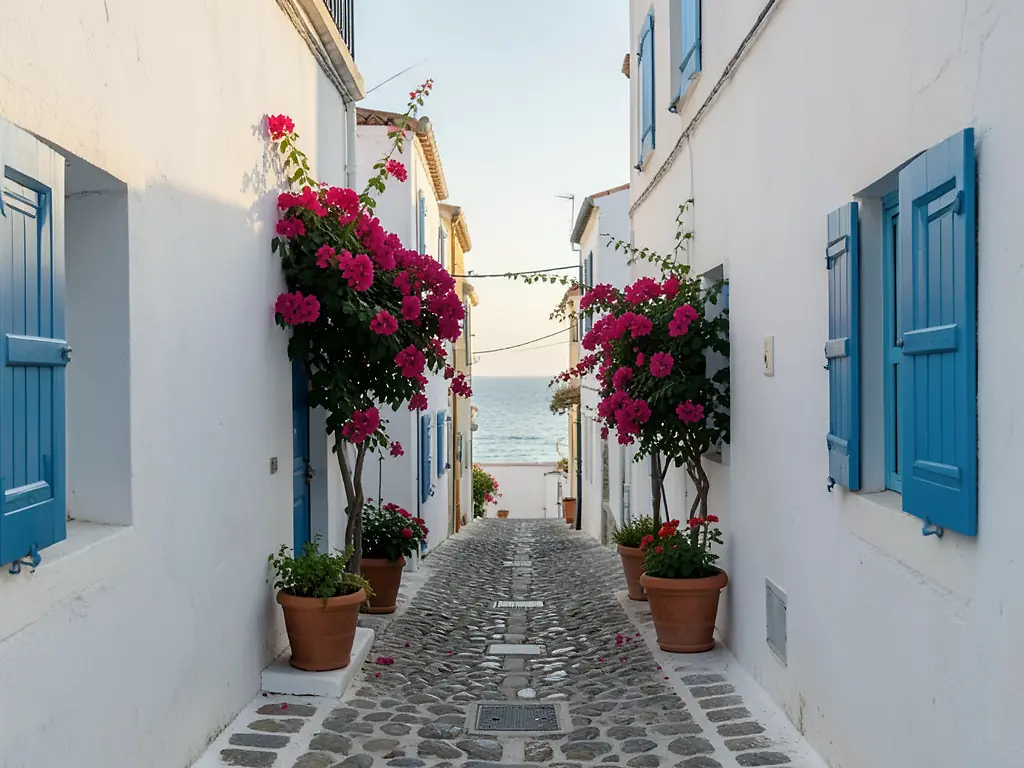 원본 PNG · AI 표시 있음SNS 사본 · 표시 사라짐AI 이미지 · 로컬 FLUX.2 klein
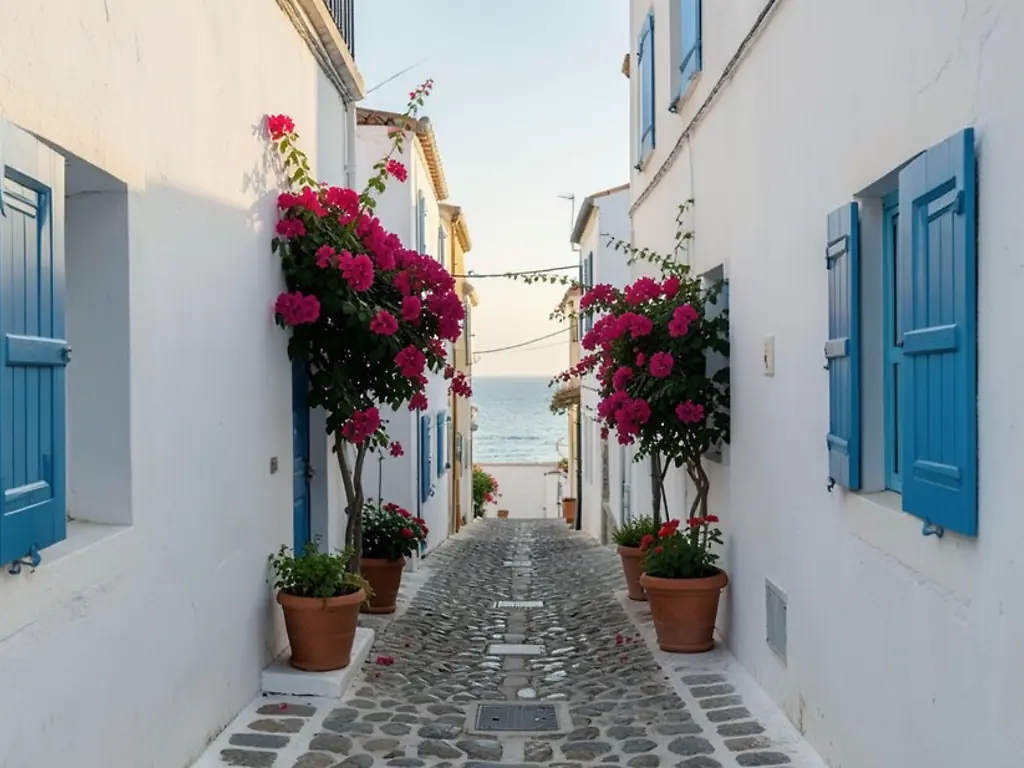
증거 A — 원본 vs SNS 사본
사건 개요
- 대상
- SNS에서 이미지·영상을 보는 일반 사용자
- 형태
- 공유하면 결과를 돌려주는 웹앱 (브라우저 안에서 판별)
- 핵심 기술
- 표시 확인(C2PA·워터마크) + SNS 압축에 강한 내용 판별
- 지금
- 이미지 웹 데모 — 실제 판별 모델이 브라우저에서 돈다 (2026-11)
배경 · 누가, 왜 지금
피드에서 본 사진이나 쇼츠가 AI로 만든 건지 궁금해도, 지금은 확인할 방법이 마땅치 않다. 만드는 쪽에는 표시 의무가 생기고 있지만, 보는 쪽이 그 표시를 확인할 도구는 없다. 게다가 표시는 SNS를 거치며 사라진다 — 그래서 표시가 없을 때 그림 자체를 봐야 한다.
원문 보기2차 자료 3건
- AI 기본법이 2026-01-22에 시행됐다. 생성물 표시 의무가 들어 있고, 주 대상은 AI 사업자이며 1년 이상 계도 기간을 둔다고 알려져 있다(2차 자료, 확인 필요).
- 공정위 추천·보증 심사지침이 2026-06-01부터 적용돼, AI 가상인물이 광고하면 인물 가까이에 “가상인물”을 표시해야 한다(2차 자료, 확인 필요).
- 플랫폼이 업로드 때 C2PA 같은 메타데이터를 지우는 경우가 많다는 보도가 있다(2차 자료, 플랫폼별로는 확인 필요 — 이것도 이 연구에서 잰다).
기록 · 2차 자료, 확인 필요
- 2026-01-22AI 기본법 시행 — 생성물 표시 의무
- 2026-06-01공정위 추천·보증 심사지침 — AI 가상인물 광고에 “가상인물” 표시
- 보도플랫폼이 업로드 때 C2PA 같은 메타데이터를 지우는 경우가 많다
증거 B — 표시 확인 1단계
파일이 스스로 밝힌 표시를 먼저 본다. 있으면 그대로 보여 주면 된다.
- C2PA 출처 정보 · OpenAI·Adobe 등이 넣는 서명된 작업 기록
- 보이지 않는 워터마크 · Meta Video Seal·Audio Seal, Adobe TrustMark
- 화면 속 “AI 생성” 문구 · 글자 인식
한계표시가 없다고 사람이 만든 것은 아니다. 구글 SynthID의 탐지기는 공개되지 않아 쓸 수 없다.
증거 C — 내용 판별 2단계
표시가 없을 때만 그림 자체를 본다.
- 점수 · 오픈소스 판별 모델
- 근거 문장 · VLM이 “어디가 왜 이상한지”를 붙임
이 연구의 기여는 이 모델을 SNS 압축에 강하게 만드는 것이다.
판정 규칙 — 확인됨 / 의심 N% / 판단 어려움
> 판별기가 틀리면 사람이 다친다. 그래서 출력 칸을 먼저 정했다 — “가짜”나 “진짜”라는 칸은 없다
- 1단계 표시 확인 → 표시 있음: AI 표시 확인됨
- 표시 없음 → 2단계 내용 판별 → 점수 높음: AI 의심 N% · 그 밖: 판단 어려움
흐름도 보기
- AI 표시 확인됨안 함서명 없는 표시는 누구나 써넣을 수 있다는 점을 숨기지 않는다
- AI 의심 N%안 함"가짜"라고 단정하지 않는다
- 판단 어려움안 함"사람이 만들었다"고 말하지 않는다
칸별 조건과 보여 주는 것표 3행
| 칸 | 언제 | 보여 줌 |
|---|---|---|
| AI 표시 확인됨 | 파일 안에 AI로 만들었다는 표시가 있을 때 | 어디에 무슨 표시가 있는지(C2PA 작업 기록·IPTC 값·워터마크·화면 문구)와 서명 검증 결과 |
| AI 의심 N% | 표시는 없고 판별 모델 점수가 기준 이상일 때 | 점수, 모델 이름, 근거 문장(어느 부분이 왜 이상한지), 사본이 얼마나 압축됐는지 |
| 판단 어려움 | 그 밖의 모든 경우 — 점수가 낮거나 애매하거나, 너무 압축된 사본 | 왜 판단하지 못했는지(표시 없음, 압축 정도, 학습에 없던 종류일 가능성) |
결과 없음 · 계획
실험 계획
판별 모델은 깨끗한 원본 파일에서는 잘 맞는다. 그런데 SNS에 올라간 사본은 줄이고 다시 압축한 파일이다. 그래서 질문은 이렇다.
SNS 압축을 흉내 내 학습한 판별기가, 실제로 인스타그램·유튜브 쇼츠·틱톡에 올렸다 다시 받은 사본에서도 버티는가? 그리고 플랫폼마다 표시(C2PA·IPTC·워터마크)는 얼마나 살아남는가?
데이터는 공개 데이터셋(GenVidBench 등)을 쓰고, 직접 만들어야 하는 AI 샘플은 내 맥의 오픈소스 로컬 모델로만 만든다. 유료 생성 API는 쓰지 않는다. 플랫폼 업로드는 직접 만든 시험 계정으로 한다.
선행 연구 원문인용 4건
- 영상 판별 벤치마크 AIGVDBench에서 AUC 95.28이 보고됐다(arXiv 2607.15321).
- SAFE 챌린지(ICCV 2025 워크숍) 보고서는 생성기를 넘나드는 일반화는 나아졌지만, 크기 조정·재압축 같은 후처리에는 여전히 약하다고 정리했다(arXiv 2605.06912).
- 압축된 비트스트림을 풀지 않고 코덱의 움직임 정보만 읽는 가벼운 판별 단계는 GenVidBench에서 AUC 0.64에 그쳤다(arXiv 2607.19476). 압축 파일 자체에서 신호를 얻기가 아직 어렵다는 뜻으로 읽는다.
- 얼굴 딥페이크 영상에서는, 플랫폼 압축을 흉내 내 미세조정한 판별기가 실제로 공유된 사본으로 학습한 것과 비슷한 성능을 냈다(arXiv 2508.08765). 일반 이미지·영상에서도 그런지는 아직 모른다.
계획한 비교 표5행 · 결과 없음
| 비교 | 데이터 | 지표 |
|---|---|---|
| 공개 판별기: 원본 파일 vs 플랫폼 왕복 사본 | 공개 데이터셋 + 인스타그램·유튜브 쇼츠·틱톡에 올렸다 다시 받은 사본 | AUC, 오탐률 5%에서의 탐지율 |
| 기준선 vs 압축 인식 학습(SNS 압축을 흉내 내 미세조정) | 같은 왕복 사본(학습에는 쓰지 않음) | 같은 지표, 플랫폼별로 따로 |
| 흉내 낸 압축으로 학습 vs 실제 왕복 사본으로 학습 | 얼굴 영상에서 보고된 결과(arXiv 2508.08765)가 일반 이미지에도 맞는지 | 두 학습의 성능 차이 |
| 플랫폼별 표시 생존율 | C2PA·IPTC·보이지 않는 워터마크·보이는 문구를 넣은 파일을 올렸다 다시 받기 | 표시별·플랫폼별로 살아남은 비율 |
| 3단계 출력의 오탐 | 사람이 찍은 사진의 왕복 사본 | "AI 의심"으로 말한 비율(상한을 먼저 정하고 기준값을 맞춤) |
| 시료 | AI일 확률 · 원본 → 재저장 |
|---|---|
| AI 그림 1다시 저장하자 떨어짐 | 원본99.8%재저장8.2% |
| AI 그림 2버팀 | 원본99.8%재저장99.3% |
| AI 그림 3원본부터 놓침 | 원본24.0% |
| 사람이 찍은 사진 | 원본0.2% |
데모에 넣은 판별 모델을 파이썬 onnxruntime으로 돌려, 로컬 오픈소스 모델(Z-Image Turbo)로 만든 그림 3장과 사람이 찍은 사진 1장을 봤다. 재저장은 긴 변 1080px · JPEG 품질 85. 막대 색은 데모 기준값(70%, 검증 전) 이상이면 AI 의심, 아래면 판단 어려움. 장수가 적어 결론이 아니라, 이 연구가 무엇을 재야 하는지 보여 주는 예시다.
역할 8개
오픈소스 구성
데모에서 지금 실제로 도는 것은 셋이다. c2pa-web(MIT)이 브라우저에서 C2PA를 읽고, Community Forensics ViT-S(CVPR 2025, MIT · 생성기 4,803개 · 270만 장으로 학습)가 판별하고, onnxruntime-web(MIT)이 서버 없이 실행한다. 나머지는 비교 실험과 영상·근거 문장 확장에 쓸 후보다.
역할별 후보와 라이선스 표8행
| 역할 | 후보 | 라이선스 | 비고 |
|---|---|---|---|
| C2PA 판독 | c2pa-rs · c2patool · c2pa-web | MIT (c2pa-web 확인) · c2pa-rs는 확인 필요 | 데모에서 c2pa-web을 브라우저로 씀 |
| 보이지 않는 워터마크 | Meta Video Seal · Audio Seal, Adobe TrustMark | Meta는 MIT · TrustMark 확인 필요 | 구글 SynthID 탐지기는 공개되지 않아 쓸 수 없음 |
| 이미지 판별 기준선 | UniversalFakeDetect(CVPR 2023) · DIRE(ICCV 2023) · NPR(CVPR 2024) | 확인 필요 | 비교 실험의 출발점 |
| 이미지 판별 (데모) | Community Forensics ViT-S(CVPR 2025) | MIT | 생성기 4,803개 · 270만 장으로 학습. 데모에서 브라우저로 실행 |
| 영상 판별 | DeMamba/GenVideo · AIGVDet | 확인 필요 | 영상 확장 단계 |
| 얼굴 딥페이크 | DeepfakeBench | 확인 필요 | 도용 광고(C 확장)에 필요 |
| 근거 문장 | Qwen-VL · Gemma 계열 VLM | 모델마다 다름 (확인 필요) | 점수에 "왜"를 붙이는 역할 |
| 브라우저 실행 | onnxruntime-web | MIT | 서버 없이 판별 |
나중에
확장: 브랜드 도용 감시
같은 엔진으로 브랜드·연예기획사가 자기 모델이나 소속 연예인 얼굴을 도용한 딥페이크 광고를 찾게 할 수 있다. 돈을 낼 쪽이 분명한 확장이다.
다만 나중에 한다. SNS를 대신 긁어 오는 건 플랫폼 약관에 걸리고, 남의 게시물을 “도용”이라고 지목했다가 틀리면 책임이 생긴다. 그래서 확장하더라도 공식 API와 사용자가 직접 보낸 신고로만 받고, 결과는 여기서와 같은 3단계로만 말한다.
위험과 대응
위험
- 오탐사람이 만든 것을 AI라고 하면 그 사람이 피해를 본다. "가짜"라는 말을 쓰지 않고, 애매하면 "판단 어려움"을 보여 준다. 기준값은 오탐 상한을 먼저 정하고 맞춘다.
- 표시 위조서명 없는 표시(XMP·EXIF)는 누구나 지우고 써넣을 수 있다. 근거로 보여 주되 C2PA 서명과 구분해서 쓴다.
- SNS 수집 약관직접 만든 시험 계정으로 올리고 다시 받은 것만 쓴다. 남의 게시물을 긁어 오지 않는다. 플랫폼별 약관 허용 범위는 확인 필요.
- 새 생성기학습에 없던 생성기는 점수가 낮게 나오기 쉽다. 낮은 점수를 "사람이 만들었다"로 읽지 않게 화면 문구로 막는다.
- 규제 변화AI 기본법 하위 규정과 계도 기간 이후 기준이 바뀔 수 있다. 표시 확인 규칙을 코드 한 곳에 모아 바꾸기 쉽게 둔다.
지금은 첫 단계
로드맵
- 이미지 웹 데모· 지금표시 확인 + 판별 모델 + 압축 실험. 이 페이지의 데모.
- 플랫폼 왕복 데이터셋시험 계정으로 올렸다 다시 받아, 표시 생존율과 기준선 성능을 잰다.
- 압축 인식 학습SNS 압축을 흉내 내 미세조정하고 왕복 사본으로 비교한다.
- 근거 문장VLM이 점수에 "어디가 왜"를 붙인다.
- 영상으로 확장같은 2단계 구조를 쇼츠·릴스 길이의 영상에 적용한다.
- 브랜드 감시 (C 확장)도용 딥페이크 광고 감시. 공식 API와 사용자 신고로만.
이 페이지의 사진은 실제 촬영이 아니라, 이 작업용 맥에서 오픈소스 모델(FLUX.2 klein 4B, Apache-2.0)로 만든 AI 이미지입니다. 사람·실제 제품은 나오지 않습니다.